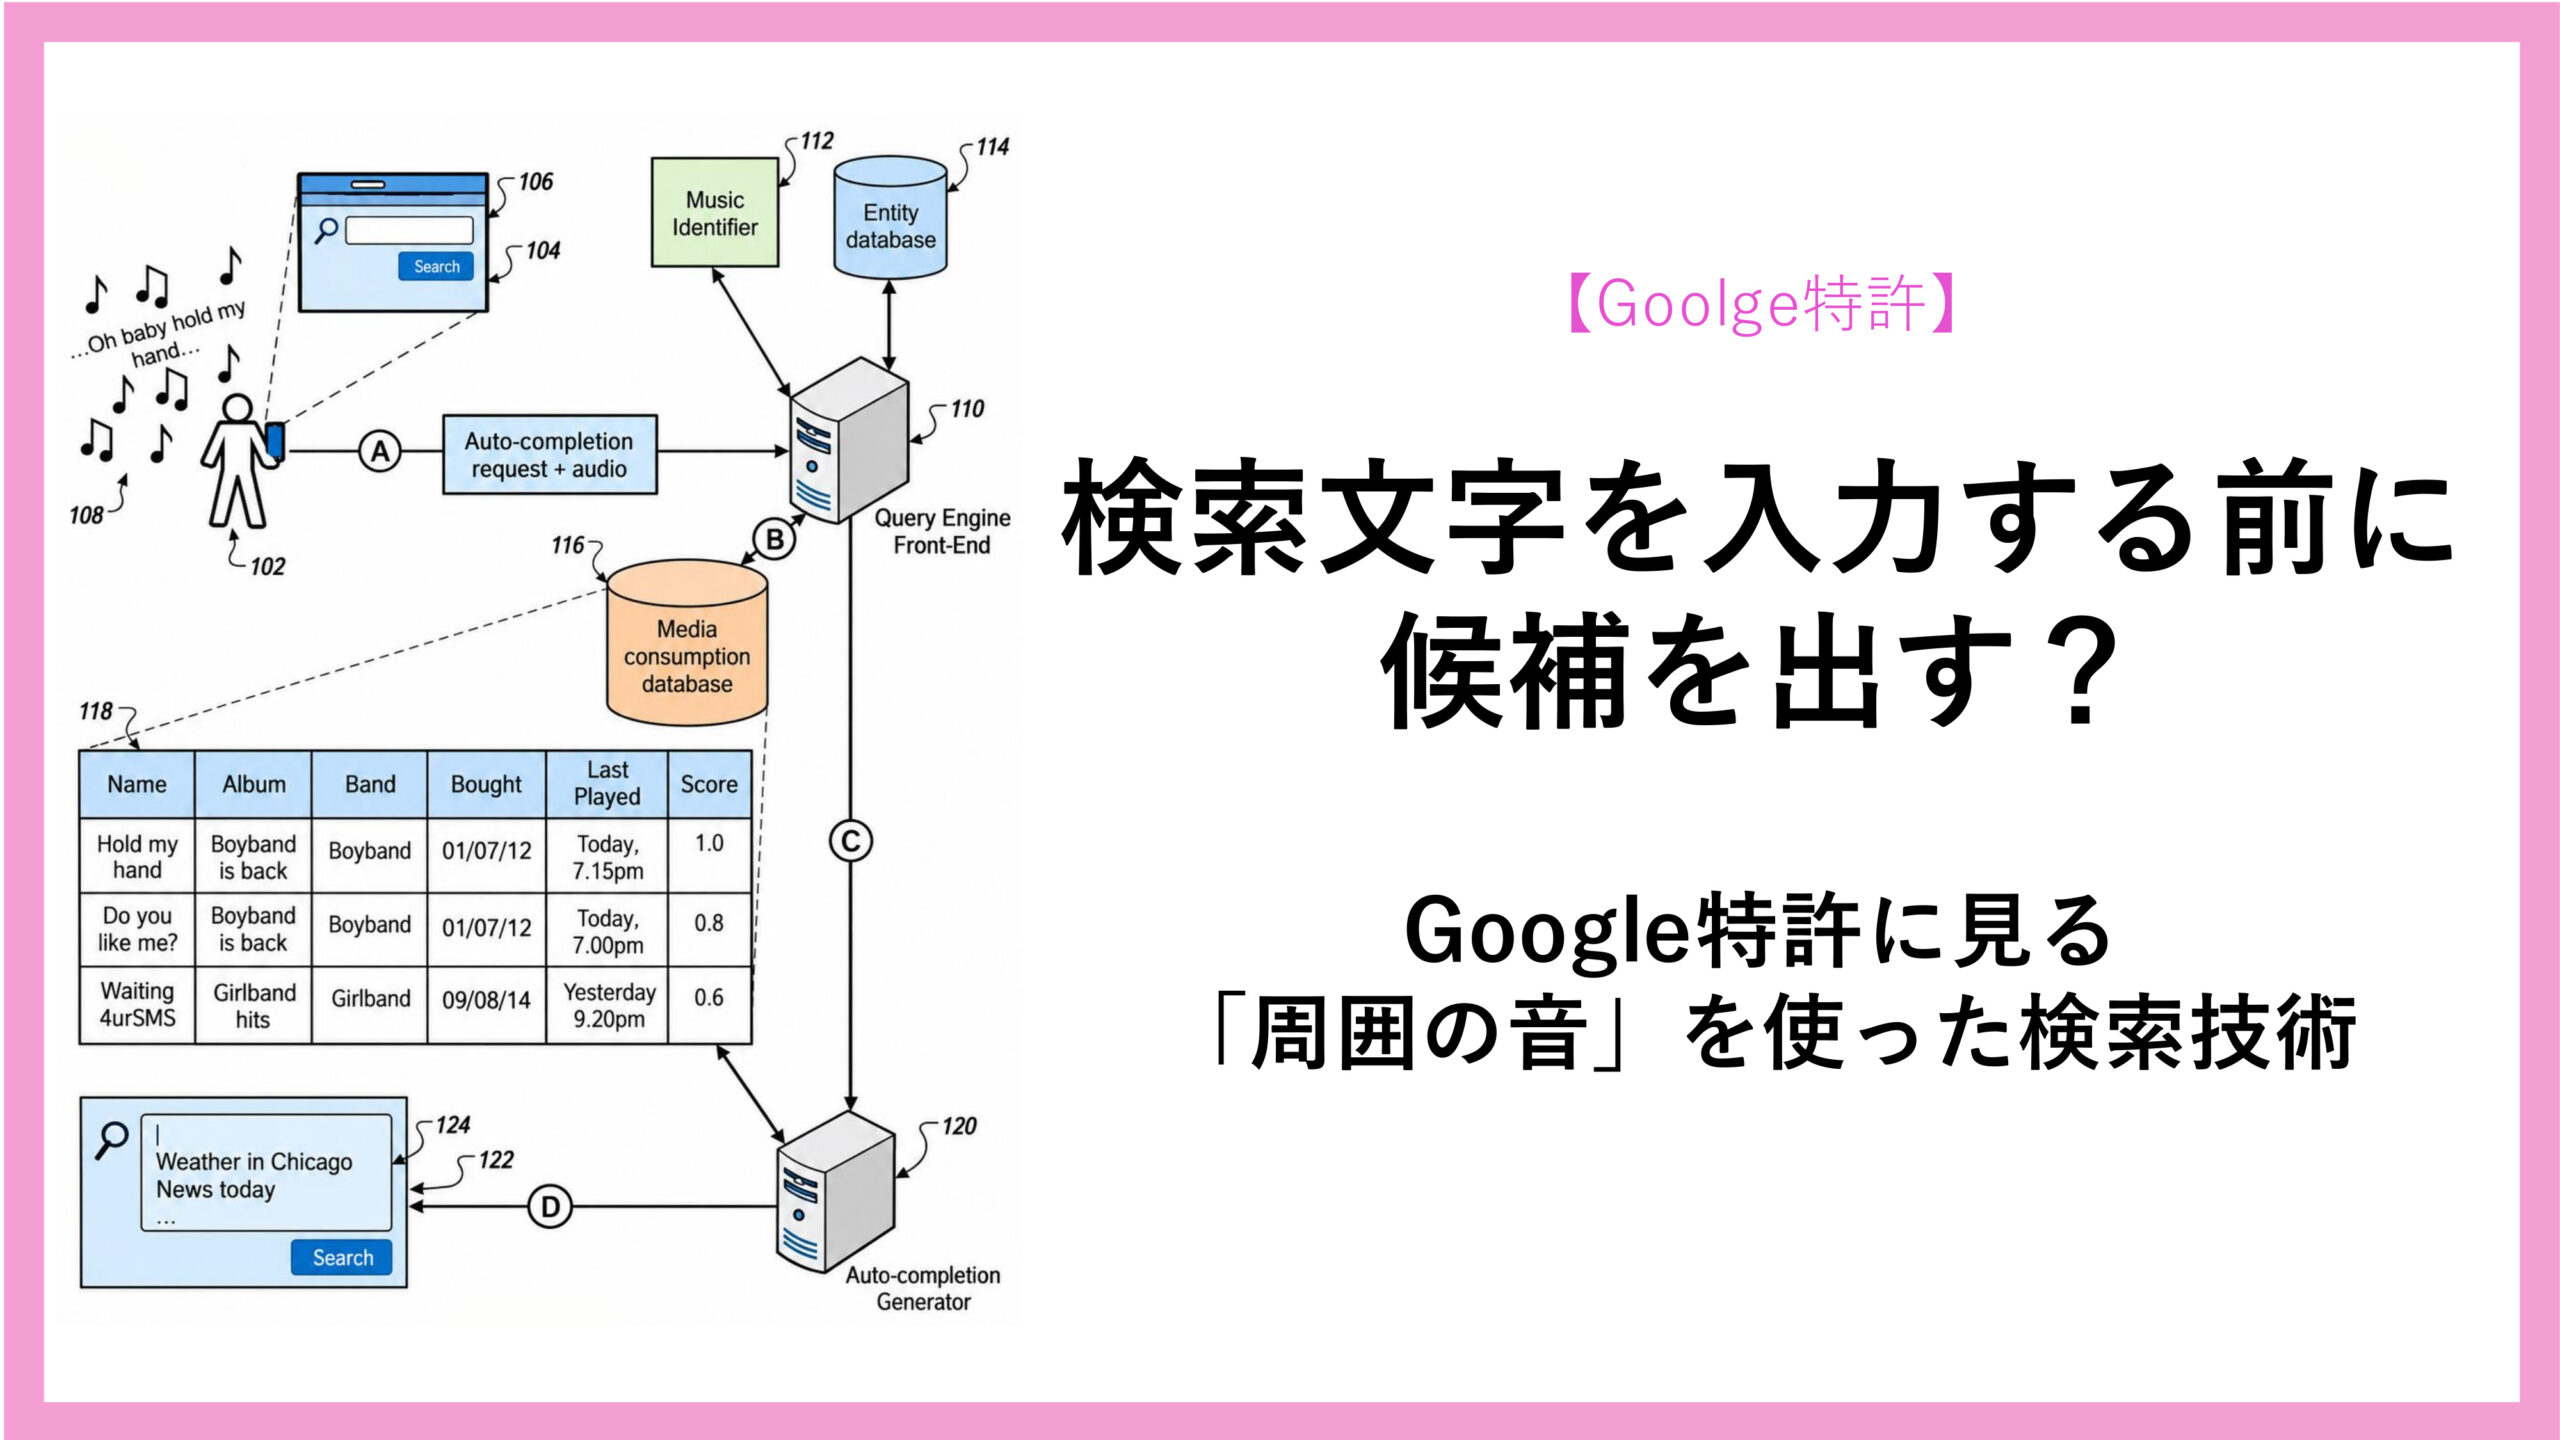
スマートフォンの検索欄に「ly」と入力すると、その続きを予測して候補が表示される。現在ではごく普通の機能です。
しかし、もしまだ1文字も入力していないのに、検索エンジンが「この人は次に何を検索しそうか」を判断するとしたら、何を手掛かりにできるでしょうか。
Googleの今回の特許では、その手掛かりとしてユーザーがいま聴いている音や、これまでに利用したメディアの履歴を使います。例えばスマートフォンの周囲で音楽が流れていれば、その背景音声から曲を識別し、その曲やアーティストに関連する検索候補を生成します。
さらに利用するのは「いま流れている音」だけではありません。過去に聴いた曲、購入したコンテンツ、最後に再生した時刻なども記録し、ユーザーとの関連度を検索候補に反映できます。
つまり、文字だけから続きを予測するオートコンプリートではなく、検索の直前にユーザーが何を見たり聴いたりしていたかまで、検索の文脈として利用する考え方です。
この記事では、この Google特許を図面を中心に読み解きながら、この技術の仕組みを読み解きます。
(詳細な図面は、US2026/0288857A1 からご参照ください。)
特許の概要
特許番号:US 2026/0288857 A1
タイトル:Media Consumption Context for Personalized Instant Query Suggest
発明者:Dhruv Bakshi、Jakob Nicolaus Foerster
出願人:Google LLC
出願日:2026/5/26
公開日:2026/9/24
特許の詳細については、US2026/0288857A1 を参照してください。
この特許は、ユーザーが視聴しているメディアコンテンツを手掛かりに、パーソナライズされた検索候補を生成する技術です。
ユーザーが見たり聴いたりしたコンテンツから、歌手、俳優、作家、監督、テレビ局などの「エンティティ」を抽出します。
エンティティとは、ここでは検索候補につなげられる人物、作品、組織などの対象です。
この特許では、ユーザーが検索セッションを開始した瞬間で、まだ検索文字を1文字も入力していない状態で、端末のマイクが取得した背景音声からメディアコンテンツを認識し、関連するエンティティに基づいて検索候補を提示します。
そして、検索候補を求める要求を受けると、ユーザーのメディアアクセス履歴から関連度の高いコンテンツやエンティティを選び、それらを検索候補へ反映します。
ポイントは、単に入力文字を高精度に予測することではありません。ユーザーが置かれている状況と検索行動をつなぎ、検索を始める前から候補を用意することに特徴があります。
検索欄を開いた瞬間から「周囲の音」を検索の文脈にする
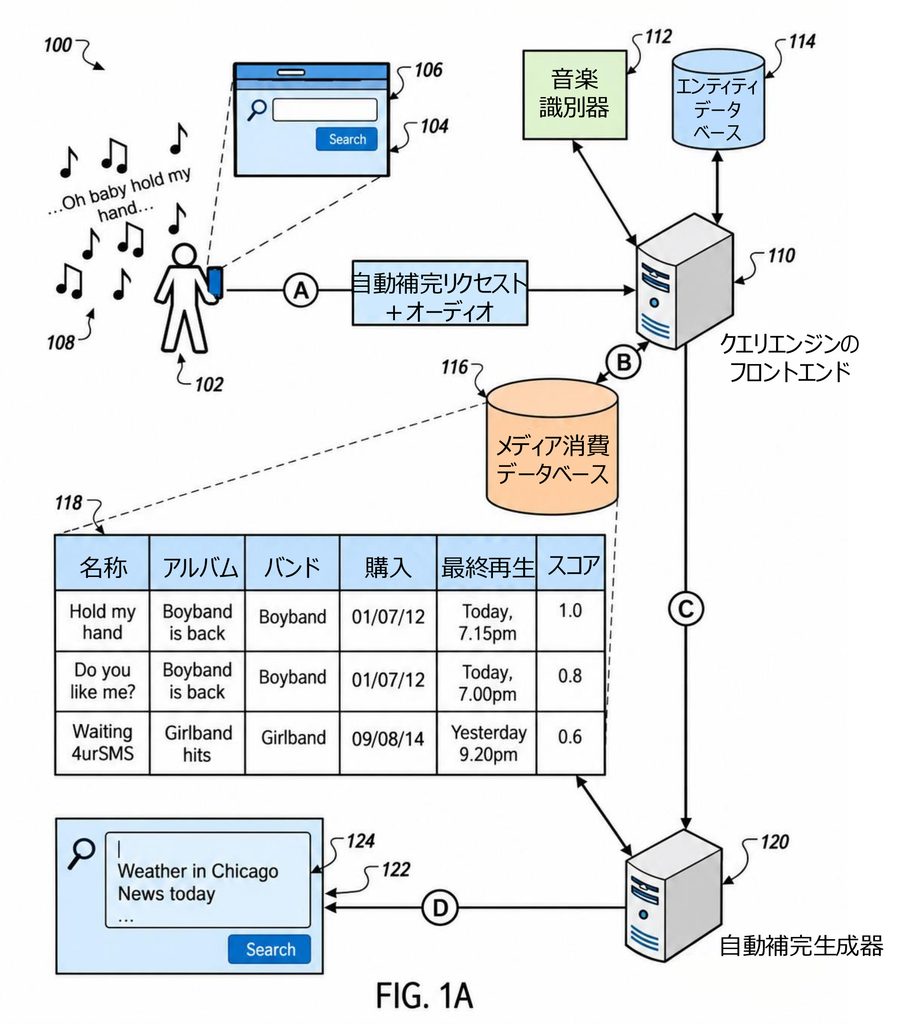
Fig.1A は、この特許のシステムを示した図です。
システム(100)は、クライアント端末(102)、クエリエンジンのフロントエンド(110)、音楽識別器(112)、エンティティデータベース(114)、メディア消費データベース(116)、自動補完生成器(120)などから構成されています。最終的な検索候補(124)は、ユーザーインターフェース(122)に表示されます。
図の上部左側では、ユーザーの周囲で音楽「…Oh baby hold my hand…」(108)が流れています。ユーザーが端末(102)の検索欄を選択すると、クエリエンジンのフロントエンド(110)が検索候補の要求を受け取ります。
このとき端末は、検索要求と一緒に周囲の背景音声を取り込んでいます。背景音声は、音楽のほか、オーディオブック、映画、テレビ番組などが想定されています。
背景音声は音楽識別器(112)へ送られます。ここで曲名、アーティストなど、音声に関連する情報を特定し、その結果がクエリエンジンのフロントエンド(110)へ返されます。
さらにメディア消費データベース(116)には、ユーザーがどのコンテンツを利用したか、そのコンテンツをいつ、どこで利用したか、どのようなエンティティと関係するかといった情報を保存できます。
FIG.1A の表(118)を見ると、「Hold my hand」などの曲名だけでなく、アルバム、バンド、購入日、最終再生時刻、スコアが並んでいます。このスコアは、ユーザーがそのコンテンツにどの程度関心を持っていると考えられるかを示す関連度として使われます。現在再生中の「Hold my hand」には高いスコアが与えられる例が示されています。
つまり、単に「マイクで曲名を当てる」技術ではありません。周囲で何が流れているかを知り、それをユーザーの過去のメディア利用情報と結び付け、検索候補の順位や内容に反映するまでが一つの流れになっています。
(正確な図面は、US2026/0288857A1 をご参照ください。)
「Lyrics」と入力すると、いま聴いている曲が候補になる
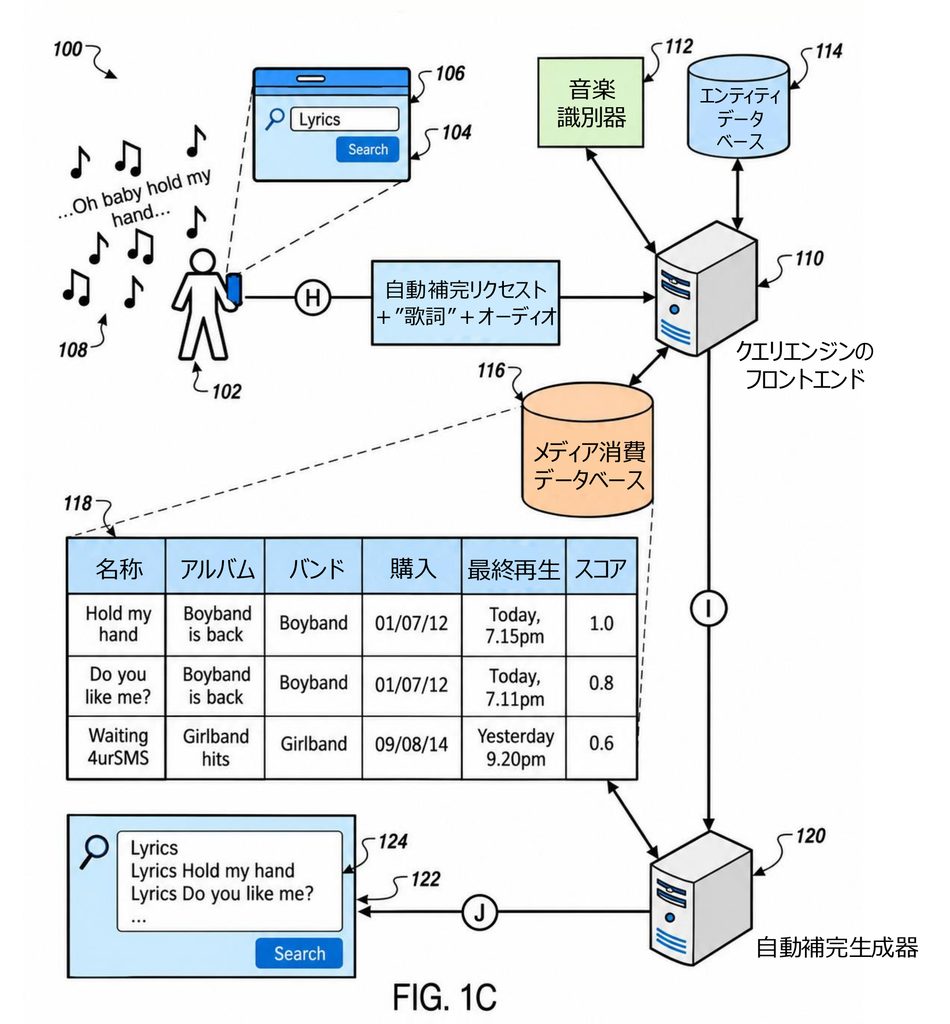
FIG.1C では、この仕組みが実際の検索画面でどのように働くのかが、より分かりやすく示されています。
ユーザーはクライアント端末(102)に「歌詞」と入力しています。一方、周囲では「…Oh baby hold my hand…」という歌詞を含む音楽が流れています。
音楽識別器(112)は、この背景音声を「Hold my hand」という曲であり、「Boyband」が演奏する曲だと識別します。その情報はメディア消費データベース(116)などと組み合わせて自動補完生成器(120)へ渡されます。
ここで「歌詞」という単語が重要になります。
自動補完生成器(120)は、候補検索語の中に含まれる「l歌詞」のような語をトリガー語として利用します。トリガー語とは、どの種類のメディアやエンティティを参照すべきか判断するための手掛かりです。
「歌詞」であれば、楽曲や歌手などとの関連を調べます。そこでメディア消費データベース(116)によって、「Boyband」が非常に関連度が高いと識別され、楽曲情報と結び付け、「歌詞 Hold my hand」「歌詞 Do you like me?」という候補(124)が提供されます。
つまり、「歌詞」という同じ文字を入力しても、ユーザーが直前に聴いていたものが違えば、検索候補の中身を変えられる可能性があります。入力された文字だけではなく、その文字を入力したときのメディア利用状況まで候補生成の材料にするわけです。
(正確な図面は、US2026/0288857A1 をご参照ください。)
「要求 → 文脈の特定 → 検索候補」という処理を5段階に整理
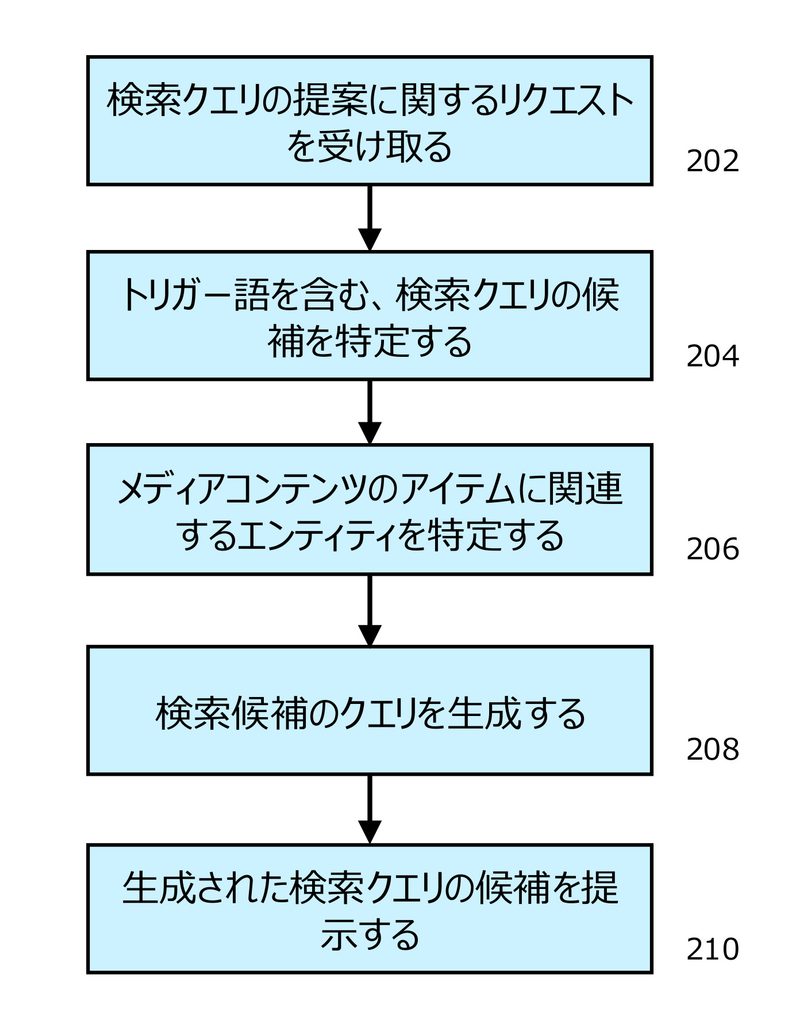
FIG.2 は、FIG.1A、FIG.1Cで描かれた具体例を、一般的な処理フローに整理した図です。
最初に、検索候補を求める要求を受信します(202)。この要求は、「weather in」のように文字がすでに入力されている場合だけではなく、ユーザーが検索欄を選択しただけで、まだ何も入力していない場合も含みます。
次に、候補検索クエリに含まれるトリガー語を特定します(204)。例えば「歌詞」であれば音楽、「俳優」であれば映画やテレビ番組との関連を調べる手掛かりになります。
続いて、メディアコンテンツに関連するエンティティを特定します(206)。この段階では、ユーザーのメディア消費データベースに保存されたコンテンツからエンティティを取り出し、それぞれに関連度スコアを持たせることもできます。
つまり、そのユーザーにとって今関連性の高い人物・作品・組織は何か、を判断してエンティティを特定しています。
そして、そのエンティティを使って検索候補を生成し(208)、ユーザーインターフェースに表示するデータを提供します(210)。
さらに、トリガー語と時間範囲を関連付ける例も記載されています。「歌詞」であれば直近2時間、「俳優」であれば過去24時間というように、検索内容によって参照するメディア利用期間を変えることも想定されています。
これは、何年も前に聴いた音楽と、数分前まで聴いていた音楽を同じように扱わないための仕組みです。
(正確な図面は、US2026/0288857A1 をご参照ください。)
その他の図面
(図面は、US2026/0288857A1 をご参照ください。)
FIG.1B は、ユーザーが「Ly」まで入力した段階を示しています。「Lyrics(歌詞) Hold my hand」のように現在の音楽に関連する候補だけでなく、「Lymes disease」のような背景音声とは直接関係しない候補も並べられる例です。つまり、メディア情報だけに検索候補を限定するのではなく、通常の候補と組み合わせて検索できることが分かります。
FIG.3 は、この検索システムを実装できる一般的なコンピュータ(300)とモバイルコンピューティングデバイス(350)の構成を示しています。コンピュータ側にはプロセッサ(302)、メモリ(304)、ストレージ(306)など、モバイル側にはプロセッサ(352)、ディスプレイ(354)、通信インターフェース(366)、トランシーバ(368)などが示されています。
考察
この特許では、「検索語をどう補完するか」という問題を、文字列処理だけではなく、周囲の状況を含めた問題として扱っている点が特徴です。
検索欄に「Lyrics」と入力しただけでは、本来は無数の候補が考えられます。しかし、数秒前までユーザーがある曲を聴いていたと分かれば、候補をかなり絞り込めます。ユーザーが追加で文字を入力する代わりに、周囲の状況が検索条件の一部を補っていると見ることができます。
一方で、パーソナライズを強くすればするほど、ユーザーが別の検索意図を持っていても、特定の候補を過度に優先してしまう可能性も考えられます。そのために、特許公報では、メディアに関連する候補と通常の検索候補を併存させる設計としています。
パーソナライズデータを扱うことには、プライバシーに対する配慮が必要です。背景音声やメディア消費履歴を利用する技術である以上、どの情報を取得し、どこまで保存するかは重要になります。特許公報でも、個人情報を収集・利用する場合にはユーザーが制御できるようにすることや、保存前に匿名化することなどが説明されています。
この特許の仕組みは音楽検索だけに限定されません。映画、テレビ番組、オーディオブックなどユーザーが見聞きしているメディアと検索を自然につなげるインターフェースへ広がる可能性があります。
この特許からは、検索を「ユーザーがキーワードを入力して始めるもの」から、ユーザーの検索行動と並行して、様々な情報から補完していくシステムへ拡張するものと考えられます。
(上記は筆者の個人的な意見です。)
まとめ
- US 2026/0288857 A1は、ユーザーが視聴・聴取しているメディアの情報を利用して、パーソナライズされた検索候補を生成する技術です。
- 背景音声を音楽識別器で識別し、メディア消費データベースなどから関連するエンティティを選び、自動補完生成器で候補を生成します。
- ユーザーが検索文字をまだ入力していない段階でも、背景音声から検索候補を提示する構成についても含まれています。
- この考え方は、文字列だけではなく「ユーザーがいま何を見聞きしているか」を検索の文脈として利用するインターフェースにつながる可能性があります。
最後までお読みいただきありがとうございました。
※企業の特許は、製品になるものも、ならないものも、どちらも出願されます。今回紹介した特許が製品になるかどうか現時点では不明です。ご注意ください。